
Expresiones regulares en JavaScript para textos en español
Sintaxis, flags y cuantificadores de las regex de JavaScript y las trampas del español: ñ y tildes, \b, código postal, DNI y NIE, IBAN, fechas e importes.
Por Redbison Dev · · Actualizado · 10 min de lectura
Edición para Español (España). Escrito para España: ñ, vocales con tilde y diéresis, signos de apertura ¿ y ¡, código postal con prefijo de provincia del 01 al 52, formato del DNI y del NIE según la Agencia Tributaria, IBAN español de 24 caracteres según el Banco de España, fechas dd/mm/aaaa e importes con coma decimal. Edición de EE. UU.
Una expresión regular (regex) describe un patrón de texto: sirve para buscar, validar y extraer datos. JavaScript las tiene integradas, y casi todos los ejemplos que circulan están pensados para el inglés. En español fallan en sitios previsibles: la ñ, las tildes, los límites de palabra y los formatos locales. Esta guía repasa la sintaxis y esas trampas con ejemplos comprobados en el probador de expresiones regulares.
Sintaxis básica
| Patrón | Significado |
|---|---|
. | cualquier carácter salvo el salto de línea |
\d, \w, \s | dígito, carácter de palabra ASCII, espacio en blanco |
[abc], [^abc] | uno de esos caracteres, ninguno de ellos |
*, +, ? | cero o más, uno o más, cero o uno |
{n}, {n,m} | exactamente n, entre n y m |
^, $ | inicio y fin del texto (o de la línea con m) |
(…), (?:…) | grupo con captura, grupo sin captura |
a|b | a o b (alternativa) |
(?=…), (?<!…) | lookahead, lookbehind negativo |
Flags
gbusca todas las coincidencias, no solo la primera.iignora mayúsculas y minúsculas.mhace que^y$funcionen por líneas.shace que.incluya el salto de línea.uactiva el modo Unicode: imprescindible para\p{…}.ybusca solo en la posición delastIndex.
La ñ y las tildes: \w no basta
En JavaScript, \w equivale a [A-Za-z0-9_]. Aplicado a «Año de mudanza en Logroño», \w+ devuelve «A», «o», «de», «mudanza», «en», «Logro» y «o»: la ñ corta las palabras. Hay dos soluciones:
- Con el flag
u,\p{L}+reconoce cualquier letra Unicode y devuelve «Año», «de», «mudanza», «en» y «Logroño». - Una clase explícita,
[a-záéíóúüñ]+con el flagi, da el mismo resultado en este texto, pero deja fuera letras como la ç o la à de nombres catalanes o franceses.
El flag i sí entiende las mayúsculas acentuadas: /ñandú/gi encuentra «ÑANDÚ» y «ñandú».
\b y las palabras con tilde
\b marca el paso entre un carácter de \w y otro que no lo es. Como la é no es \w, /\bcafé\b/g no encuentra nada en «Pedí un café. Otro café»: después de la é no hay límite de palabra. La alternativa son lookarounds con letras Unicode:
/(?<!\p{L})café(?!\p{L})/gu
Este patrón encuentra los dos «café».
Para buscar sin distinguir tildes, cami[oó]n con i encuentra «camión», «camion» y «CAMIÓN». Si hay muchas palabras, es más práctico normalizar el texto antes de buscar: texto.normalize('NFD').replace(/\p{Diacritic}/gu, '') convierte «camión» en «camion». Cuidado: también convierte la ñ en n.
Formatos españoles
Código postal
Tiene cinco cifras y, según la normativa postal publicada en el BOE, los dos primeros dígitos identifican la provincia según el Código Geográfico Nacional; Ceuta y Melilla tienen el 51 y el 52. Los códigos de provincia del INE van del 01 (Araba/Álava) al 52 (Melilla), así que un patrón más estricto que \d{5} es:
/\b(?:0[1-9]|[1-4]\d|5[0-2])\d{3}\b/g
En «Envío a 28013 Madrid, 08001 Barcelona y 53001, pedido 1234567» encuentra «28013» y «08001», y rechaza «53001» y el número de pedido. Que el código exista de verdad solo se sabe consultando el callejero de Correos.
DNI y NIE
Según la Agencia Tributaria, el NIF de un español es el número del DNI, ocho dígitos (los primeros pueden ser ceros) más una letra de control; el NIE de un extranjero tiene una letra inicial X, Y o Z, siete dígitos y un carácter de verificación alfabético. Un patrón de forma:
/\b(?:\d{8}|[XYZ]\d{7})[A-Z]\b/g
En «DNI 12345678Z, NIE X1234567L, mal 1234567Z» encuentra los dos primeros y descarta el de siete cifras. La letra final se calcula a partir del número, y comprobarla exige aritmética que una regex no hace: valida la forma con la regex y la letra con código.
IBAN
El Banco de España explica que un IBAN español tiene 24 caracteres: ES, dos dígitos de control, cuatro de entidad, cuatro de oficina, otros dos de control y diez del número de cuenta. Aceptando espacios cada cuatro caracteres:
/ES\d{2}(?: ?\d{4}){5}/g
encuentra tanto «ES91 2100 0418 4502 0005 1332» como «ES9121000418450200051332». Los dígitos de control se comprueban con un cálculo, no con la regex.
Fecha dd/mm/aaaa
/\b(0[1-9]|[12]\d|3[01])\/(0[1-9]|1[0-2])\/(\d{4})\b/
En «Firma: 07/11/2026» captura «07», «11» y «2026». También acepta «31/02/2026»: una regex comprueba el formato, no el calendario. Para eso, crea la fecha y comprueba que el día no ha cambiado.
Importes con coma decimal
En España el decimal es la coma y los millares se marcan con punto, pero los números de cuatro cifras se escriben sin punto: 2500 €, no 2.500 €. El patrón que suele copiarse de ejemplos alemanes, \d{1,3}(?:\.\d{3})*(?:,\d{2})?(?= ?€), en «Total: 1.234,56 €, 89,90 € y 12.500 €; 2500 €» devuelve «1.234,56», «89,90», «12.500» y… «500», porque corta el 2500. Empezando con \d+:
/\d+(?:\.\d{3})*(?:,\d{2})?(?= ?€)/g
devuelve «1.234,56», «89,90», «12.500» y «2500».
Signos de apertura
Las preguntas y exclamaciones españolas se abren con ¿ y ¡. [¿¡][^?!]*[?!] extrae «¿Qué tal?» y «¡Hola!» de «¿Qué tal? ¡Hola!».
Codiciosa o perezosa
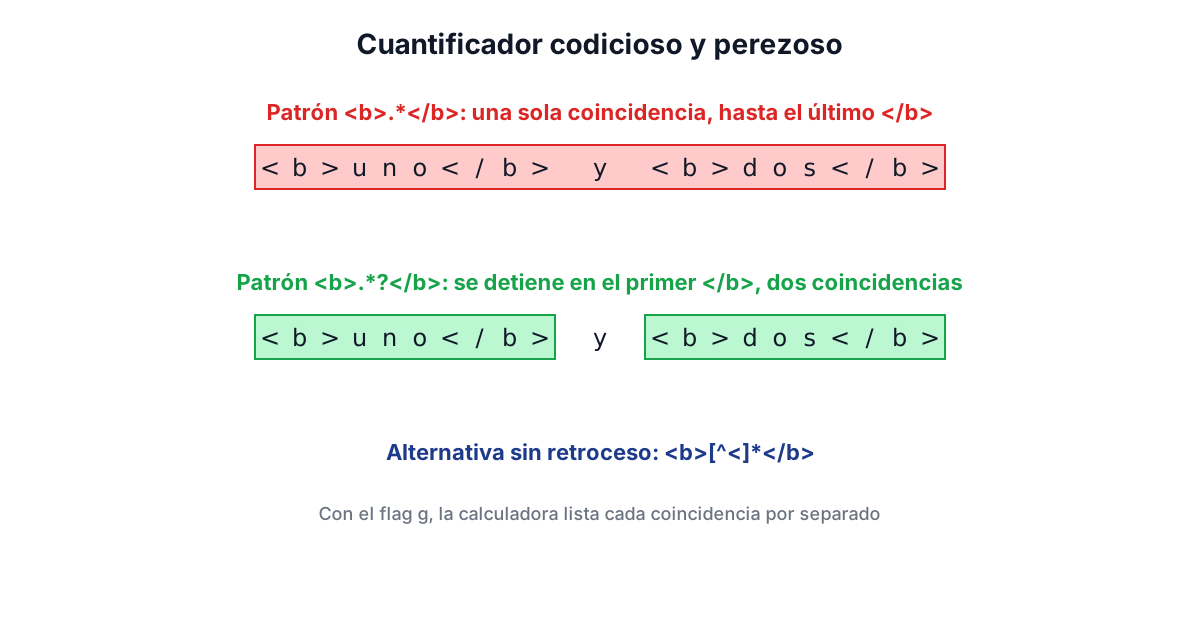
Los cuantificadores son codiciosos: toman todo lo que pueden. En <b>uno</b> y <b>dos</b>, el patrón <b>.*</b> encuentra todo el texto de una vez. Con ? se vuelven perezosos: <b>.*?</b> encuentra «<b>uno</b>» y «<b>dos</b>» por separado. A menudo es mejor una clase negada, <b>[^<]*</b>, que no necesita retroceder.
Retroceso catastrófico
Cuantificadores anidados como (a+)+$ pueden obligar al motor a probar un número exponencial de combinaciones cuando el texto casi coincide. Con una entrada de usuario, eso bloquea el navegador o el servidor. Evita anidar cuantificadores sobre lo mismo, usa clases negadas y limita la longitud de la entrada.
Una trampa de JavaScript: lastIndex
Una regex con g o y guarda en lastIndex dónde terminó la última búsqueda. Si se reutiliza con test(), la segunda llamada empieza donde acabó la primera:
const re = /a/g;
re.test('a'); // true
re.test('a'); // false, lastIndex era 1
Crea la regex dentro de la función o pon re.lastIndex = 0 antes de cada uso.
Cómo probar un patrón
- Pega en el probador un texto real con casos buenos y malos, incluidos ñ, tildes y números de cuatro cifras.
- Activa solo los flags que necesitas; añade
uen cuanto haya\p{…}o emojis. - Mira los grupos capturados, no solo si hay coincidencia.
- Prueba los bordes: cadena vacía, espacios al principio y al final, mayúsculas.
La guía original en inglés usa ejemplos con formatos estadounidenses.
Preguntas frecuentes
¿Por qué \w no encuentra la ñ?
Porque en JavaScript \w solo incluye letras ASCII, dígitos y el guion bajo. Usa \p{L} con el flag u o una clase como [a-záéíóúüñ].
¿Cómo se valida un código postal español con regex?
Con \b(?:0[1-9]|[1-4]\d|5[0-2])\d{3}\b: cinco cifras con un prefijo de provincia entre 01 y 52.
¿Hay una regex para comprobar la letra del DNI?
No. Una regex comprueba la forma (ocho dígitos y una letra, o X, Y o Z, siete dígitos y una letra); la letra de control se calcula con código.
¿Cómo es una regex para un IBAN español?
ES\d{2}(?: ?\d{4}){5} acepta los 24 caracteres con o sin espacios. Los dígitos de control se verifican aparte.
¿Qué diferencia hay entre .* y .*?
.* es codicioso y abarca lo máximo posible; .*? es perezoso y se detiene en la primera coincidencia del resto del patrón.
Fuentes y lecturas recomendadas
- Orden de 27 de septiembre de 1995 sobre modificación del código postal de Ceuta y Melilla, BOE. Los dos primeros dígitos identifican la provincia; 51 y 52 para Ceuta y Melilla.
- Lista estándar de provincias, Instituto Nacional de Estadística. Códigos del 01 al 52.
- Composición del NIF de las personas físicas, Agencia Tributaria. Formato del DNI, del NIE y de los NIF K, L y M.
- ¿Qué se esconde tras los números de tu cuenta corriente?, Portal del Cliente Bancario, Banco de España. Estructura del IBAN español.
- Expresiones regulares, MDN Web Docs. Sintaxis y flags de JavaScript.
- Escape de clase de carácter Unicode \p{…}, MDN Web Docs.
- ECMAScript Language Specification: objetos RegExp, Ecma International (TC39).
Abrir Probar expresiones regulares (regex)
More Procesamiento de texto
Every tool in the Procesamiento de texto section, free and in your browser.
- Procesador de texto en línea
- Eliminar líneas duplicadas
- Buscar entradas duplicadas
- Eliminar espacios sobrantes
- Eliminar líneas vacías
- Conversor de mayúsculas y minúsculas
- Conversor de líneas a texto separado por comas
- Conversor de comas a líneas
- Escapar y quitar el escape de caracteres
- Probar expresiones regulares (regex)
- Generador de nubes de palabras